Claude Code と Codex の両方を使えるのに、どちらに何を任せるかを決められない人、1つのAIに開発を全部任せるやり方に限界を感じている人に向けた記事です。読み終えると、自分の開発でAIに役割を分けるか、分けるならどこから始めるかを決められます。材料は2026-11-10 09:55 時点の開発記録1件で、開発はまだ終わっておらず、アプリは未完成です。記録上の担当名は Claude/Codex で、動かしている製品は Claude Code と Codex CLI です(運営者に確認)。以下は記録の担当名で書きます。
2026-11-10 に、読む人の課題から始まる順に組み替えました。記録の内容と時点は変えていません。
先に断っておくと、1つのAIに全部を頼むやり方との比較は、今回はしていません。この記事で書けるのは、役割を分けた場合に実際に何が起きたか、だけです。「この方法ならうまくいく」と言える段階でもありません。うまくいかなかった所も含めて、記録のとおりに書きます。
AIに役割を分けるとは、何を分けることか
AIオーケストレーション開発とは、複数のAIに役割を割り振り、順番に仕事を渡しながら開発を進めるやり方です。オーケストラの指揮のように、全体の進行を取りまとめる役がいます。
今回の記録では、テストとコードについて作る役と確かめる役を別のAIにして、仕事の受け渡しを会話ではなく指示書と報告書(どちらもファイル)で行っています。全体の進行を取りまとめる役もAIです(以下、進行役のAI)。進行役のAIの仕事として記録に残っているのは、指示書を書いて担当のAIに渡し、返ってきた結果を確かめ、足りなければ戻すことの繰り返しでした。
今回の記録で分けていたのは「作る」と「確かめる」で、そのあいだを指示書と報告書でつないでいました。そのぶん工程と文書は増えます。終わった33工程のそれぞれに、指示書と報告書が1本ずつ残っていました。
Claude・Codex・Antigravity の誰に何を任せるか:記録での割り振り
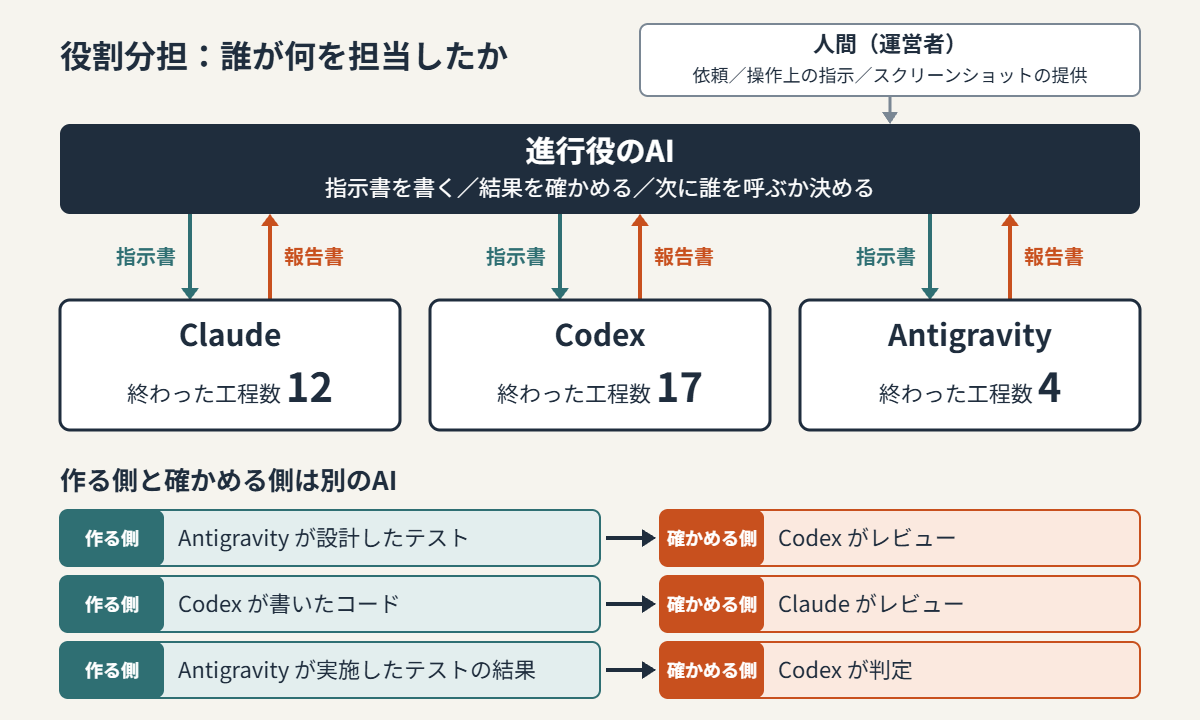
どのAIに何を任せるかを決めるときの参考として、今回の割り振りをそのまま載せます。この記事では、どのAIが何に向いているかは比べていません。進行役のAI(記録上の呼び名は「PM補佐」)が、3種類のAIに仕事を割り振っています。
| 担当 | 受け持った仕事 | 終わった工程数 |
|---|---|---|
| 進行役のAI | 指示書を書く/結果を確かめる/次に誰を呼ぶか決める/アプリを起動して画面を確かめる | (工程の外) |
| Claude | 要件(何を作るかの決めごと)の整理、機能設計、設計とコードのレビュー(セキュリティ・実行環境・コード) | 12 |
| Codex | 事前調査、保存形式の設計、実装(プログラムを書くこと)と直し、テスト設計とテスト結果のレビュー | 17 |
| Antigravity | システムテスト(完成に近いアプリを実際に操作して、決めたとおりに動くかを確かめる試験)の設計と実施 | 4 |
| 人間(運営者) | 依頼、操作上の指示、スクリーンショットの提供(実機での確認2項目はこれから) | — |
表の「レビュー」とは、作ったものを別の担当が読み、足りない所を指摘することです。進行役のAIは、記録上の担当名に Claude が付いています。進行役を含めても、AIの種類は3つです。
テストとコードでは、作る側と確かめる側は別のAIになっています。Antigravity が設計したテストを Codex がレビューし、Codex が書いたコードを Claude がレビューし、Antigravity が実施したテストの結果を Codex が判定しています。いま挙げた3つの組のうち、Claude と Codex の2つだけでできている組は、Codex が書いたコードを Claude がレビューした所です。設計は別で、後の工程表のとおり、機能設計も、設計のレビュー(セキュリティと実行環境)も Claude の担当でした。
役割を分けるかどうかを決める3つの問い
分けるかどうかを決める前に、自分に聞いておく問いを3つ挙げます。この1件の記録から読み取れる範囲のもので、効果を確かめたものではありません。
- 作ったAIとは別の目で確かめたい物があるか。記録では、終わった33工程のうち、差し戻し(レビュー担当が「このままでは次へ進めない」と判定して、前の工程へ戻すこと)は5回ありました。5回とも、レビューの対象を作ったのとは別の種類のAIが出しています。
- 工程と文書が増えることを受け入れられるか。記録では、33工程のそれぞれに指示書と報告書が1本ずつありました。33工程が終わるまでの記録の期間は約11時間(夜間の待ち時間を含みます)で、その時点でアプリは未完成です。
- 自分で画面を見て確かめる時間を取れるか。記録では、AIどうしの確かめでは見つからず、人間が撮ったスクリーンショットから見つかった不具合がありました。単体試験(部品1つずつを、プログラムで自動的に確かめる試験)が12件すべて通っていたのに、画面では一覧が最初の1回しか描かれない不具合もありました(こちらは進行役のAIの画面確認で見つかっています)。
3つとも「はい」と答えられるなら、次の節の5つから、自分の開発に写すものを選ぶ段階です。「いいえ」があるときにどうするのがよいかは、この記録からは言えません。
どこから分けるか:記録から写せる5つのこと
ここからは、今回の記録で実際に行われていたことのうち、小さく切り出せそうなものを挙げます。2つの役だけで回す形など、もっと小さな構成は今回の記録では試していません。効果を確かめたものではない、という前提で読んでください。
- 作る役と確かめる役を分ける。記録では、差し戻し5回は、すべてレビューの対象を作ったのとは別の種類のAIが出しています。
- 指示書に「してはいけないこと」と「完了条件」を書く。読んだ3本の指示書には、担当・許された判定・してはいけないこと・出していいもの・完了条件がそろっていました(33本すべては読んでいません)。
- 判定に「判定できない」を用意する。記録では、合格か不合格かの2択ではなかったので、準備の問題で確かめられなかった2項目が、どちらにも数えられずに残っています。
- 指摘はまとめて直し、直した所だけ見直す。後半の「場面2」で行われていたやり方です。
- 自動の試験が通った後に、画面を見る。後半の「場面3」で見つかった2つの不具合は、どちらも実際の画面を見て分かったものでした。
1番目は、AIを2つ以上使うことが前提です。2番目から5番目は指示書の書き方と確かめ方の話で、AIの数を前提にしていません(AIが1つの場合に試した記録はありません)。どれから始めるのがよいかは、この記録からは言えません。
指示書に入れる項目(写して使う枠)
2番目の項目を、そのまま写せる枠にします。項目名は、読んだ3本の指示書にそろっていたものです。中身は自分の作業に合わせて埋めてください。
- 担当:
- 許された判定:
- してはいけないこと:
- 出していいもの:
- 完了条件:
記録では、作業は「作業ツリー(本体とは別に用意した作業用のフォルダ)」の中だけで行い、本体には触らない決まりが、指示書の冒頭に書かれていました。
根拠にした記録:何を作り、どの順で進めたか
ここまでの割り振りと問いと5つのことが、どんな記録から出てきたのかを示します。
題材:YouTubeライブのコメント管理ツール「LiveJazzup」
題材は、運営者が自分の配信用に作っている「LiveJazzup」というデスクトップアプリ(パソコンに入れて使うアプリ)です。YouTubeライブの配信中に流れるコメントを一覧で見て、スーパーチャットやメンバー加入も同じ一覧に表示し、初めてコメントした人に印を付け、同時接続数を表示します。後から機能を足せる仕組みと、実際の配信につながずに作り物のコメントを流して試せる「模擬の配信」も、最初の段階で作ります。
- 記録の期間:2026-11-09 22:38 〜 2026-11-10 09:55(約11時間。夜間の待ち時間を含みます)
- 終わった工程:33(09:55 の時点で34番目の工程が進行中)
- 状態:未完成。システムテストのやり直しと、人間による実機での確認はこれからです
工程の流れ:33工程を7つの段にまとめる
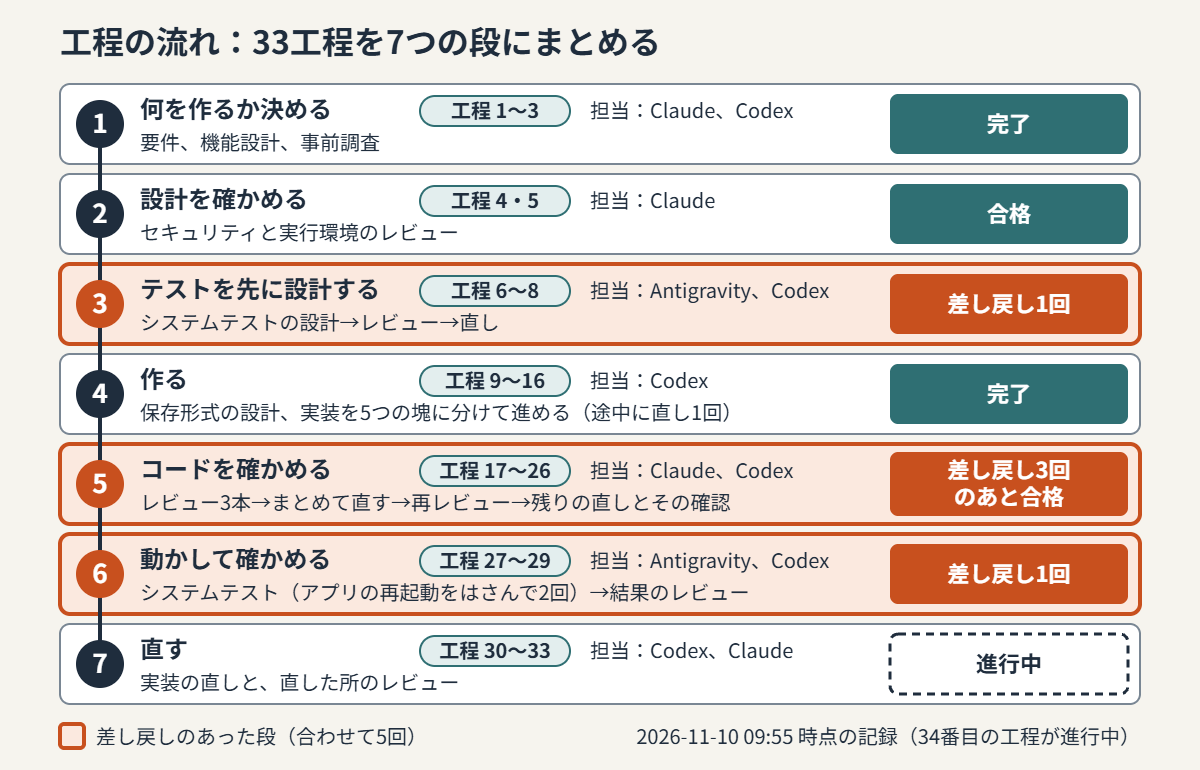
| 段 | 工程(番号) | 担当 | 結果 |
|---|---|---|---|
| 1. 何を作るか決める | 要件、機能設計、事前調査(1〜3) | Claude、Codex | 完了 |
| 2. 設計を確かめる | セキュリティと実行環境のレビュー(4・5) | Claude | 合格 |
| 3. テストを先に設計する | システムテストの設計→レビュー→直し(6〜8) | Antigravity、Codex | 差し戻し1回 |
| 4. 作る | 保存形式の設計、実装を5つの塊に分けて進める(9〜16。途中に直し1回) | Codex | 完了 |
| 5. コードを確かめる | レビュー3本→まとめて直す→再レビュー→残りの直しとその確認(17〜26) | Claude、Codex | 差し戻し3回のあと合格 |
| 6. 動かして確かめる | システムテスト(アプリの再起動をはさんで2回)→結果のレビュー(27〜29) | Antigravity、Codex | 差し戻し1回 |
| 7. 直す | 実装の直しと、直した所のレビュー(30〜33) | Codex、Claude | 進行中 |
進行役のAIは、工程が終わるごとに報告書を読み、進捗の記録に1段落を書き足し、次の指示書を出しています。
役割を分けても残った問題:差し戻し5回の中身
役割を分ければ問題が出なくなる、という記録ではありません。5回の差し戻しは、3つの場面に分かれます。
場面1:テストの設計が、実装の前に差し戻された(1回)
Antigravity が設計したテスト項目に、Codex が4件の指摘を出しました。
- 画面の文字だけでは合否を決められない項目があった
- 要件と反対のことを合格条件にしている項目があった
- 合格条件のうち、どこを見て確かめるかが決まっていないものがあった
- まだ登録していない道具を「登録済み」として準備の手順を書いていた
進行役のAIは4件とも妥当と判断し、「項目は増やさずに直す」と指示しました。直した後はレビューをやり直さず、進行役が自分で検査して確かめています。プログラムを書き始める前に、テスト側の問題が見つかった場面です。
場面2:コードのレビュー3本が、3本とも差し戻しになった(3回)
実装が終わった後、Claude がセキュリティ・実行環境・コードの3つの観点でレビューしました。結果は3本とも差し戻しです。レビュー文書に書かれた指摘は、合わせて「直すべき」7件、「望ましい」15件でした。
進行役のAIは1本ごとに直させず、3本が出そろうのを待って、まとめて1回で直させています。「直すべき」7件はすべて、「望ましい」は14件を直す対象にし、残る1件は直さないと決めて指示書に書いていました。直した後は、直した所だけをもう一度レビューして、3本とも合格になりました。
この直しの中で、処理の重さを測る道具を作っています。測ったのは「模擬の配信の出来事(コメントなど)を15,000件流したときの、1件あたりの処理時間」です。アプリの画面は起動せず、中核の部分だけで測っています。
- 直す前に相当する方式:1件あたり 19.1ミリ秒
- 直した後:1件あたり 0.14ミリ秒
直す前は、出来事が1件届くたびに一覧の全件を複製して画面へ配っていました。これを、追加された分だけ配る形に変えています。直す前の値は実測そのものではありません。15,000件のうち300点を抜き出して全件複製の時間を測り、直した後の処理時間に足して出した「相当値」だと、報告書に書かれています。実際に5分間流して画面が追いつくかは、システムテストで見る決まりでした。
場面3:システムテストの結果が差し戻された(1回・未解決)
Antigravity がシステムテスト15項目を実施し、Codex がその記録を読んで判定しました。試験は模擬の配信だけで行われています。
| 判定 | 件数 |
|---|---|
| 合格 | 10 |
| 不合格 | 3 |
| 判定できない | 2 |
「判定できない」の2項目は、試験を始める前から、模擬の視聴者24人分のデータが保存先に入っていたことが原因でした。進行役のAIが事前の確かめで同じ保存先を使っていたためで、レビュー担当は「試験の準備の問題」と判定しています。この2項目が合格なのか不合格なのかは、やり直すまで分かりません。
不合格の3項目のうち1つは、次の節で書く人間のスクリーンショットから見つかったものです。
さらに、不合格を直した後の進行役の画面確認で、別の不具合が見つかりました。一覧が最初の1回しか描かれないというもので、単体試験は12件すべて通っていました。単体試験で使っていた作り物の画面と、本物の画面とで、部品の振る舞いが違っていたためです。
差し戻しとは別に数えると、実装の直しの工程は09:55 の時点で7つ終わり、8つ目が進行中でした。終わった7つのうち3つと、進行中の8つ目は、進行役のAIが自分でアプリを起動して確かめたときに見つけた食い違いがきっかけです。残りの4つは、差し戻しを受けたものが2つ、レビューの「望ましい」指摘を先に直したものが2つでした。
人間の手はどこで要ったか:関わった所と待ち時間
記録に残っている人間(運営者)の関与は、次の3つです。
- 最初の依頼:依頼書に、何を作りたいかという人間の要望が引用の形で残っています。
- 操作上の指示:進行役のAIが作業用の画面(端末のタブ)を自分で開かないように、という指示です。進行役はこれを原文のまま記録し、以後は従っています。
- スクリーンショットでの不具合発見:人間がアプリ本体の窓で模擬の配信を流し、その画面を撮ったところ、画像が壊れた印で表示されていました。AIのシステムテストはブラウザ用の入口から行っていたため、この不具合に当たっていませんでした。
待ち時間も1か所あります。システムテストの直前、03:46 の記録に、テスト用の道具の登録が「許可待ち」と書かれ、次の記録は09:04 でした。およそ5時間あいています。この間に終わった工程はシステムテストの1回目だけで、その記録に残る時刻は8時50分台です。誰の許可を待っていたのかは、記録に書かれていません。
一方で、進行役のAIが判断に行き詰まって人間に判断を仰ぐ「エスカレーション」は、記録上0回です。また、人間による実機での確認(2項目)は、まだ記録がありません。
まとめ:役割を分けるかどうかを決める前に
- AIオーケストレーション開発は、複数のAIに役割を割り振り、指示書と報告書で仕事を渡していく進め方です。
- 記録での割り振りは、テストとコードについて、作る側と確かめる側を別のAIにする形でした(設計と設計のレビューはどちらも Claude の担当)。Claude と Codex の2つだけでできている組は、Codex が書いたコードを Claude がレビューした所です。
- 分ける前に聞いておく問いは、別の目で確かめたい物があるか、工程と文書が増えることを受け入れられるか、自分で画面を見て確かめる時間を取れるか、の3つです。
- 今回の記録では、約11時間(待ち時間を含む)で33工程が終わり、差し戻しは5回(3つの場面)でした。
- システムテストは合格10・不合格3・判定できない2で、やり直しはこれからです。アプリは未完成です。
開発が進んで結果が変わったら、この記事にも追記します。
コメント